AI SSD是什么 ?能解决大模型运行的哪些问题?
AI SSD详细科普,选购指南
导读
买 SSD 时,我们已经习惯了比较参数:读写速度如何?使用寿命长吗?
但在 AI 场景下,这个问法正在失效。真正决定 AI 快不快的,往往不是"硬盘跑分有多高",而是数据能不能持续、稳定、低延迟地送到计算单元。
这篇文章讲清三件事:AI 为什么改变了存储的角色、AI SSD 到底"新"在哪里、以及为什么它并不只是"更快的 SSD"。
过去很多年里,当我们谈到 SSD、固态硬盘,第一反应通常是"速度更快的硬盘"。
装系统、装游戏、保存照片和视频、运行软件、读取大型文件——这就是 SSD 最典型的工作。
它的任务也很明确:把数据保存下来,并在需要的时候交给 CPU。
但在大模型训练、推理、RAG、AI Agent、长上下文以及本地 AI 这些场景里,情况变了。数据规模越来越大,模型越来越大,计算越来越依赖数据能否及时到达 GPU、CPU、内存和其他加速器。
于是一个过去容易被忽略的问题,开始变得越来越重要:
计算芯片越来越快之后,数据从哪里来?又如何足够快、足够稳定地送到计算单元?
这正是 SSD 正在发生的变化:从传统意义上的"存储设备",走向 AI 基础设施里的数据供给层。
所以,AI 时代真正发生的改变,并不是简单地"SSD 变快了",而是——
SSD 开始从"保存数据",走向"理解 AI 数据访问规律,并参与 AI 数据路径优化"。
普通 SSD:把数据存好,然后尽快交出去
理解 AI SSD,得先理解普通 SSD 的定位。
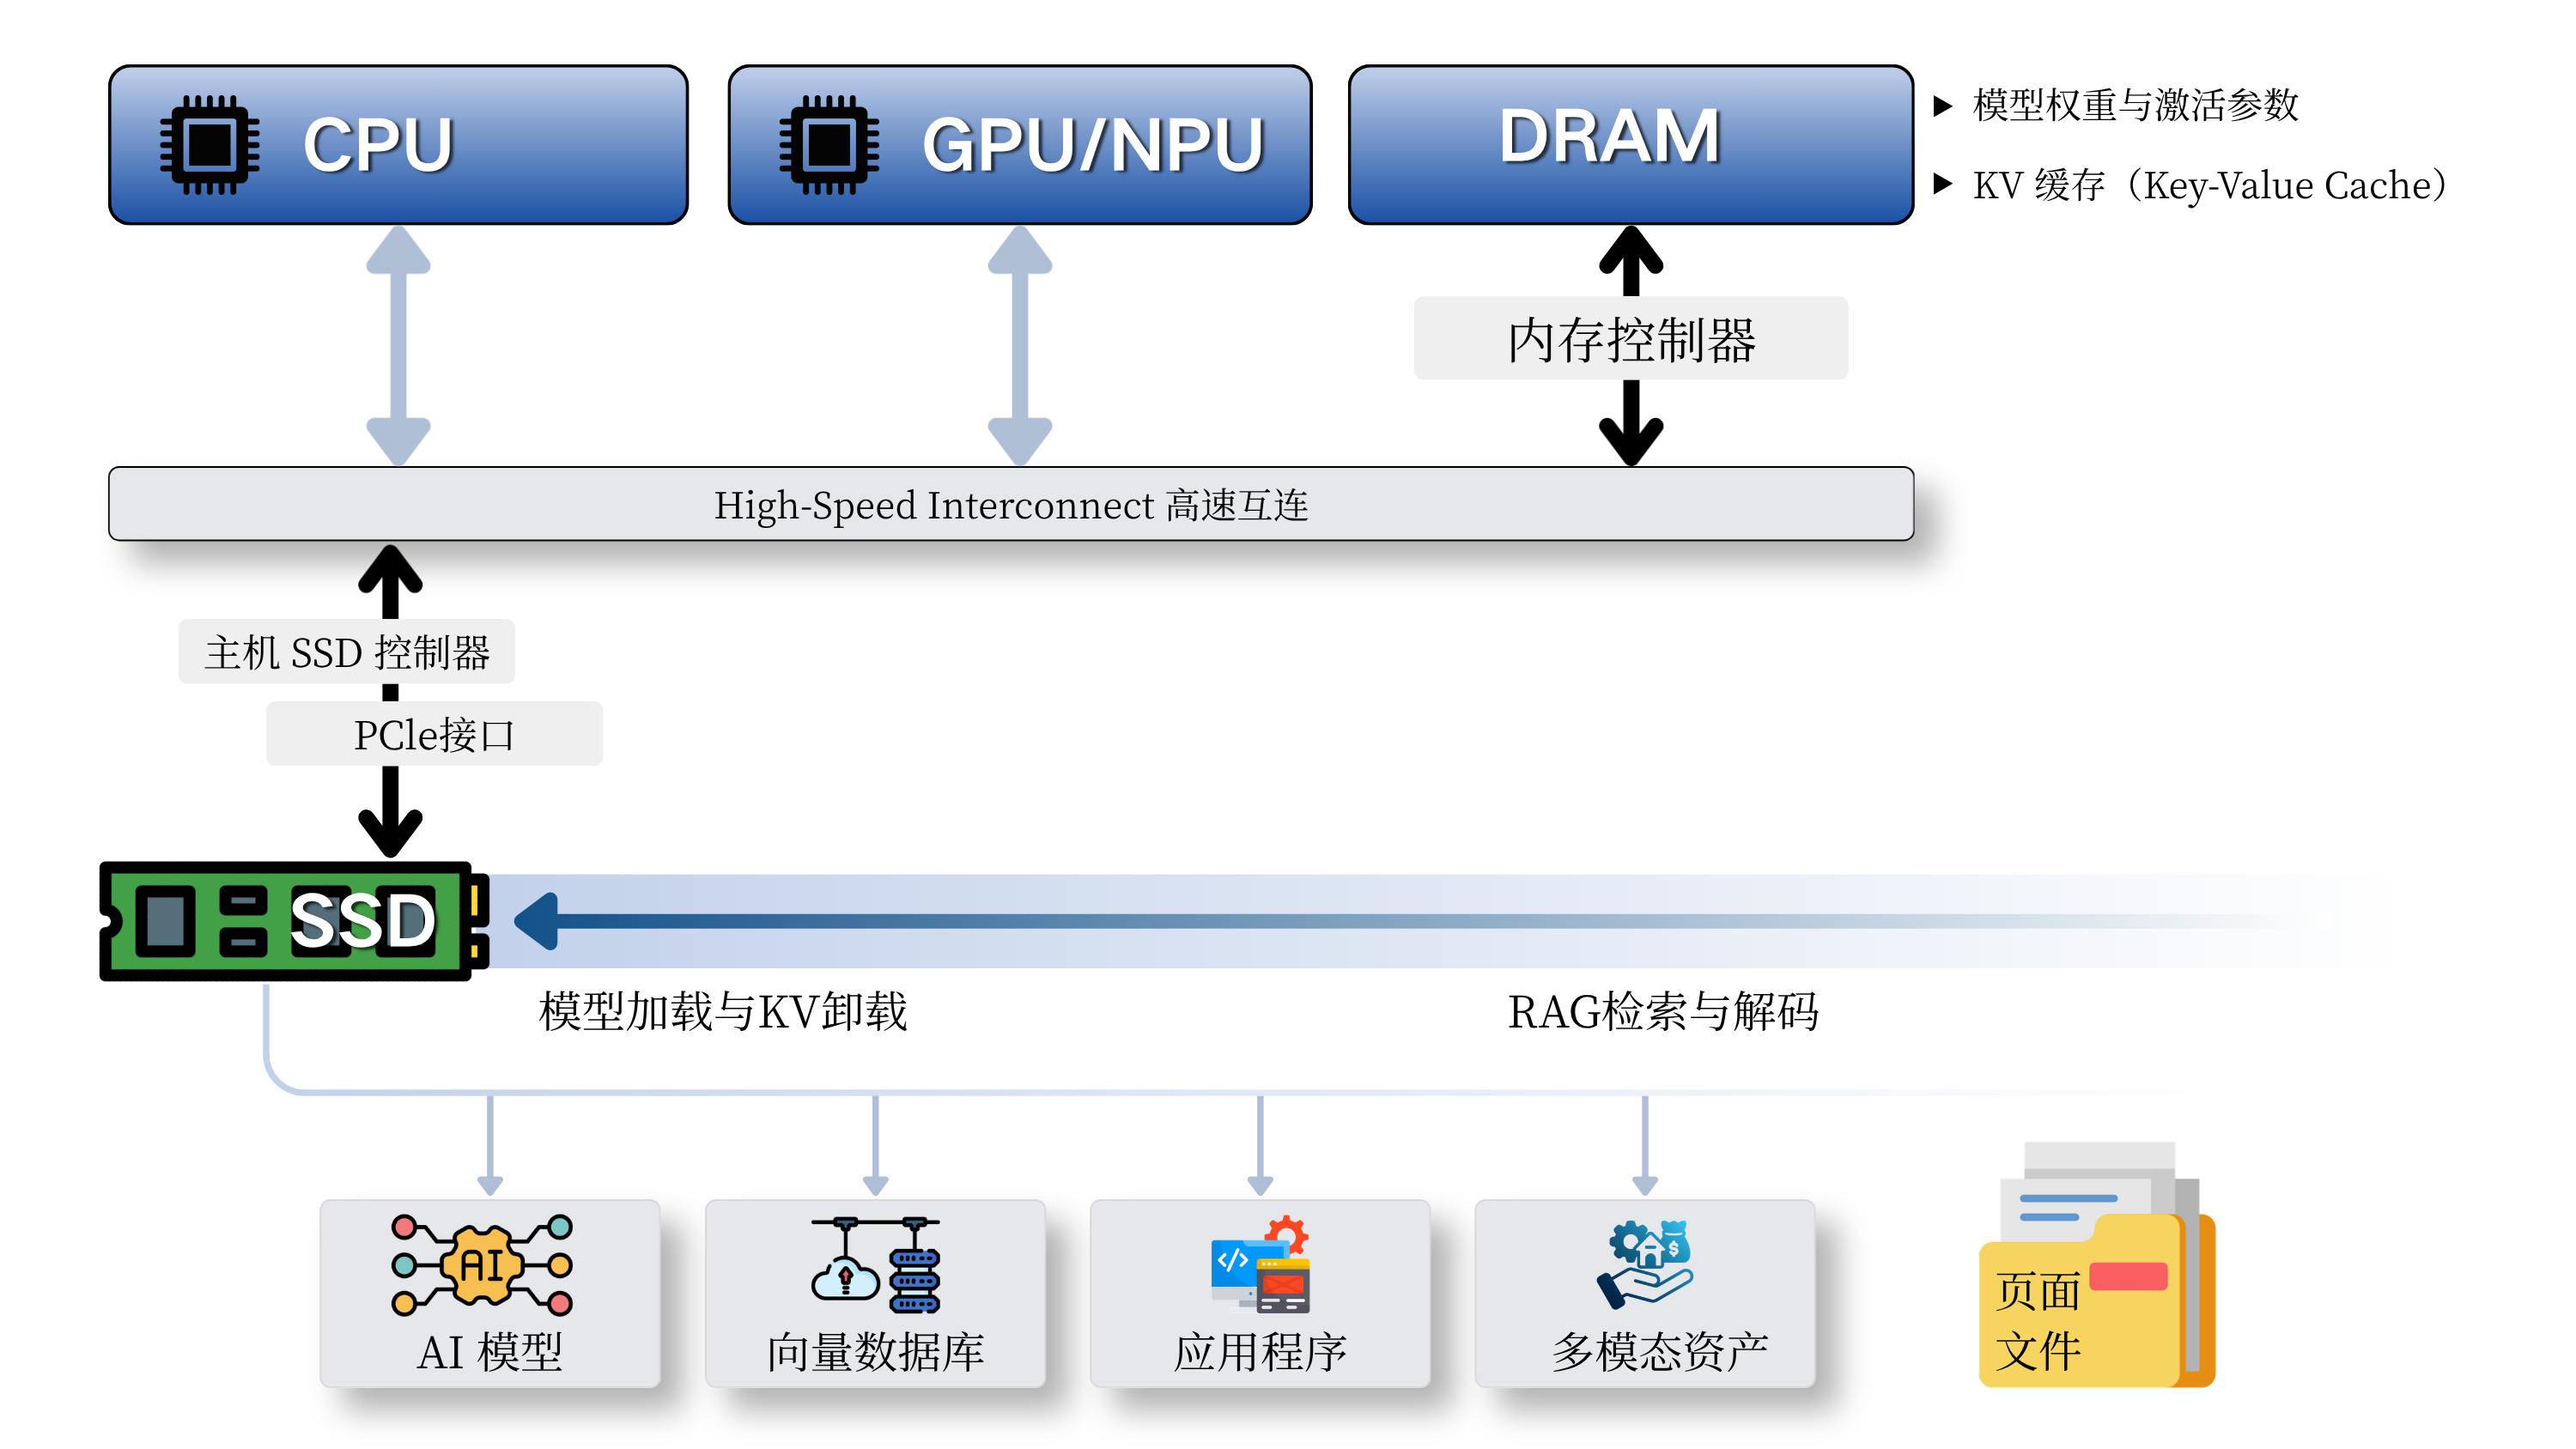
普通 SSD 本质上是一种非易失性存储设备:负责长期保存数据,断电之后数据依然存在。以普通 PC 为例,系统中的数据大致是这样的层级:
CPU / GPU → 内存 / 显存 → SSD → 其他长期存储
距离计算单元越近,访问越快,但容量越小、成本越高
因此普通 SSD 的任务非常清楚:在容量、速度、可靠性和成本之间取得平衡。
在消费级电脑里,它主要承担系统盘、应用程序、游戏、照片视频和文件存储;在服务器里,企业级 SSD 则更多承担数据库、虚拟机、日志、数据集、模型文件和检查点(Checkpoint)等工作。
而 NVMe 的出现,进一步提升了 SSD 的数据通道效率。按 NVM Express 官方资料,NVMe 最初就是为了通过 PCIe 更高效地连接非易失性存储而设计,相比传统 SATA 提供更低延迟、更高扩展性的接口能力——这也是今天多队列并行访问的基础。
所以普通 SSD 的核心逻辑,可以概括成一句话:
"我把数据保存好,在你需要的时候尽可能快地给你。"
这套逻辑在过去的计算时代非常有效。但 AI 出现之后,它开始不够用了。
AI 为什么让存储的重要性突然上升?
因为 AI 对"数据"的需求,和传统软件完全不是一个量级。
一个普通办公软件,打开一次可能只需要加载几十 MB、几百 MB 数据;一款大型游戏,需要持续加载资源;而大模型可能需要读取几十 GB、几百 GB,甚至更大的模型权重、数据集、检查点以及上下文相关数据。
更重要的是,AI 不只是"读取一次"。它可能需要:
反复读取 · 持续读取 · 并行读取 · 随机读取 · 长时间高负载读取
把这句话拆到具体场景里,会更直观:
| 训练 | 不断读取海量训练数据,同时周期性写入 Checkpoint |
|---|---|
| 推理 | 快速加载模型、访问知识库、处理上下文,并越来越多地处理 KV Cache 等运行时状态 |
| Agent | 一次任务连续调用多个模型、访问多个数据源,并维持长时间上下文 |
这意味着,AI 对存储的要求已经变了:
从"容量够不够",转向"数据能不能持续、稳定、低延迟地供应给计算系统"。
这不是某一家的判断。三星、Micron、Solidigm 等存储厂商近年的公开资料都在强调同一个趋势:随着 AI 训练和推理规模扩大,存储正在直接影响数据加载效率、加速器利用率,以及整个 AI 系统的成本和响应能力。
NVIDIA 在 GPUDirect Storage 的设计文档中也直接指出:如果 I/O 位于关键路径上,数据在存储、CPU 内存和 GPU 之间的搬运就可能成为瓶颈,减少不必要的数据复制和搬运,可以降低这类开销。
这就是 AI 时代 SSD 面临的新命题。
普通 SSD 在 AI 场景里,卡在哪四个地方?
先强调一个非常重要的事实:普通 SSD 并不是不能用于 AI。
实际上,现在大量 AI 服务器使用的,依然是普通意义上的高性能企业级 NVMe SSD。真正的问题在于:传统 SSD 的设计目标,并不是专门针对 AI 工作负载优化的。 它能完成 AI 的存储任务,但当 AI 工作负载越来越复杂,一些原本不明显的问题开始被放大。
瓶颈一|容量与层级:不只是"更大"的问题
模型越来越大,数据集越来越大,KV Cache 和其他运行时数据也在增长。SSD 的容量虽然远大于 DRAM 和 HBM,但它毕竟只是存储层,无法简单等价于内存或显存。
瓶颈二|数据搬运带来的性能损失
传统架构可以简单理解成 SSD → CPU → 内存 → GPU,数据要经过多个层级。而 AI 加速器的计算速度越来越快:如果 GPU 在等数据,昂贵的计算资源就没有被充分利用。
瓶颈三|访问模式和传统应用不一样
普通 SSD 的很多性能参数,是围绕顺序读写、随机 I/O、IOPS、吞吐量和延迟设计的。但 AI 更关心的是:什么时候读、读什么、连续多久读、数据能否稳定供应,以及不同数据之间如何协同。 尤其在推理场景中,长上下文、KV Cache 和多轮 Agent 工作流会让数据访问更加复杂——因此单纯提高"顺序读取速度",并不能解决所有 AI 存储问题。
瓶颈四|高负载下的稳定性更加重要
AI 工作负载往往不是"短时间跑一下":训练任务可能运行数小时甚至数天,AI 服务则可能持续运行。因此在这个场景里,峰值速度不是唯一指标,稳定性、QoS、延迟一致性、写入耐久度以及功耗都越来越重要。 这也是为什么数据中心 AI SSD 往往强调企业级 NAND、控制器、散热、功耗和持续负载性能。
AI SSD 是什么?一次"角色升级"
这里特别容易产生一个误区:
AI SSD ≠ 里面装了一块 AI 芯片的 SSD
AI SSD是一种针对 AI 工作场景负载深度优化的固态存储设备。
换句话说:AI SSD 的重点不是给 SSD 强行加一个"AI"标签,而是让存储设备更理解 AI 工作负载。
如果一定要用一句话区分两者:
| 普通 SSD 解决的是 | 如何把数据存得好、读得快 |
|---|---|
| AI SSD 更关注 | 如何让 AI 系统更高效地使用这些数据 |
展开到具体维度对比,会更清楚:
| 对比维度 | 普通 SSD | AI SSD |
|---|---|---|
| 核心定位 | 通用数据存储 | 面向 AI 工作负载优化的存储 |
| 主要目标 | 容量、速度、可靠性、成本 | 数据供给效率、延迟、吞吐、搬运效率 |
| 典型负载 | 系统、软件、游戏、文件 | 模型、训练数据、KV Cache、RAG、推理数据 |
| 关注性能 | 顺序读写、随机 IOPS、延迟 | 持续吞吐、QoS、访问延迟、数据路径效率 |
| CPU 参与 | 通常承担较多数据搬运 | 更强调减少 CPU 搬运与系统开销 |
| GPU 数据路径 | 传统 PCIe / 软件栈 | 可结合更直接的路径,例如 GDS |
| 发展方向 | 更高容量、更高性能 | 存储、内存、计算进一步融合 |
普通 SSD 关注"存储性能",AI SSD 开始关注"系统性能"。这是两者最大的定位差异。
AI SSD 已经解决了哪些问题?
前面四个 PART 讲的是"AI 为什么需要一种新的存储"。但更直接的问题是:AI SSD 到底解决了什么?
答案是四个非常具体的问题——而且不是愿景,是已经在产品上跑通的事实。
问题一:显存、内存不够,大模型根本跑不起来
过去:想跑大模型,先看显卡够不够大,显存不够,模型连加载都过不去。
AI SSD 给出的答案: 让存储真正进入内存层级。热数据留在显存,装不下的权重和上下文下沉到内存与 SSD,由高速 SSD 持续供给计算单元——显存不再是大模型的硬性门槛。
问题二:数据搬运太慢,GPU 一直在空等
过去:数据要走 SSD → CPU → 内存 → GPU 一整条链路,算力越强,空等越浪费。
AI SSD 给出的答案: 更直接的数据通路加上万兆级的持续吞吐,让数据供给的速度跟得上算力——GPU 把时间花在计算上,而不是等硬盘。
问题三:长对话每次都要重算上下文,一等就是一两分钟
过去:上下文越长,首字等待越久,聊到后面几乎没法用。
AI SSD 给出的答案: 让上下文缓存持久化在专用区域,下一次对话直接供给、无需重算——首字等待从分钟级进入秒级。
问题四:AI 高频读写,普通 SSD 扛不住
过去:AI 负载日复一日地高频写入,写入放大让 NAND 寿命消耗很快,"用两年就得换盘"。
AI SSD 给出的答案: 给 AI 负载划出专属缓存分区承接高频读写,配合写入管理与更高的耐用等级——长时间高负载运行,也不用担心把盘写坏。
这四件事的共同点是:它们解决的都不是"快一点",而是"原本做不到的事,现在可以做了"。
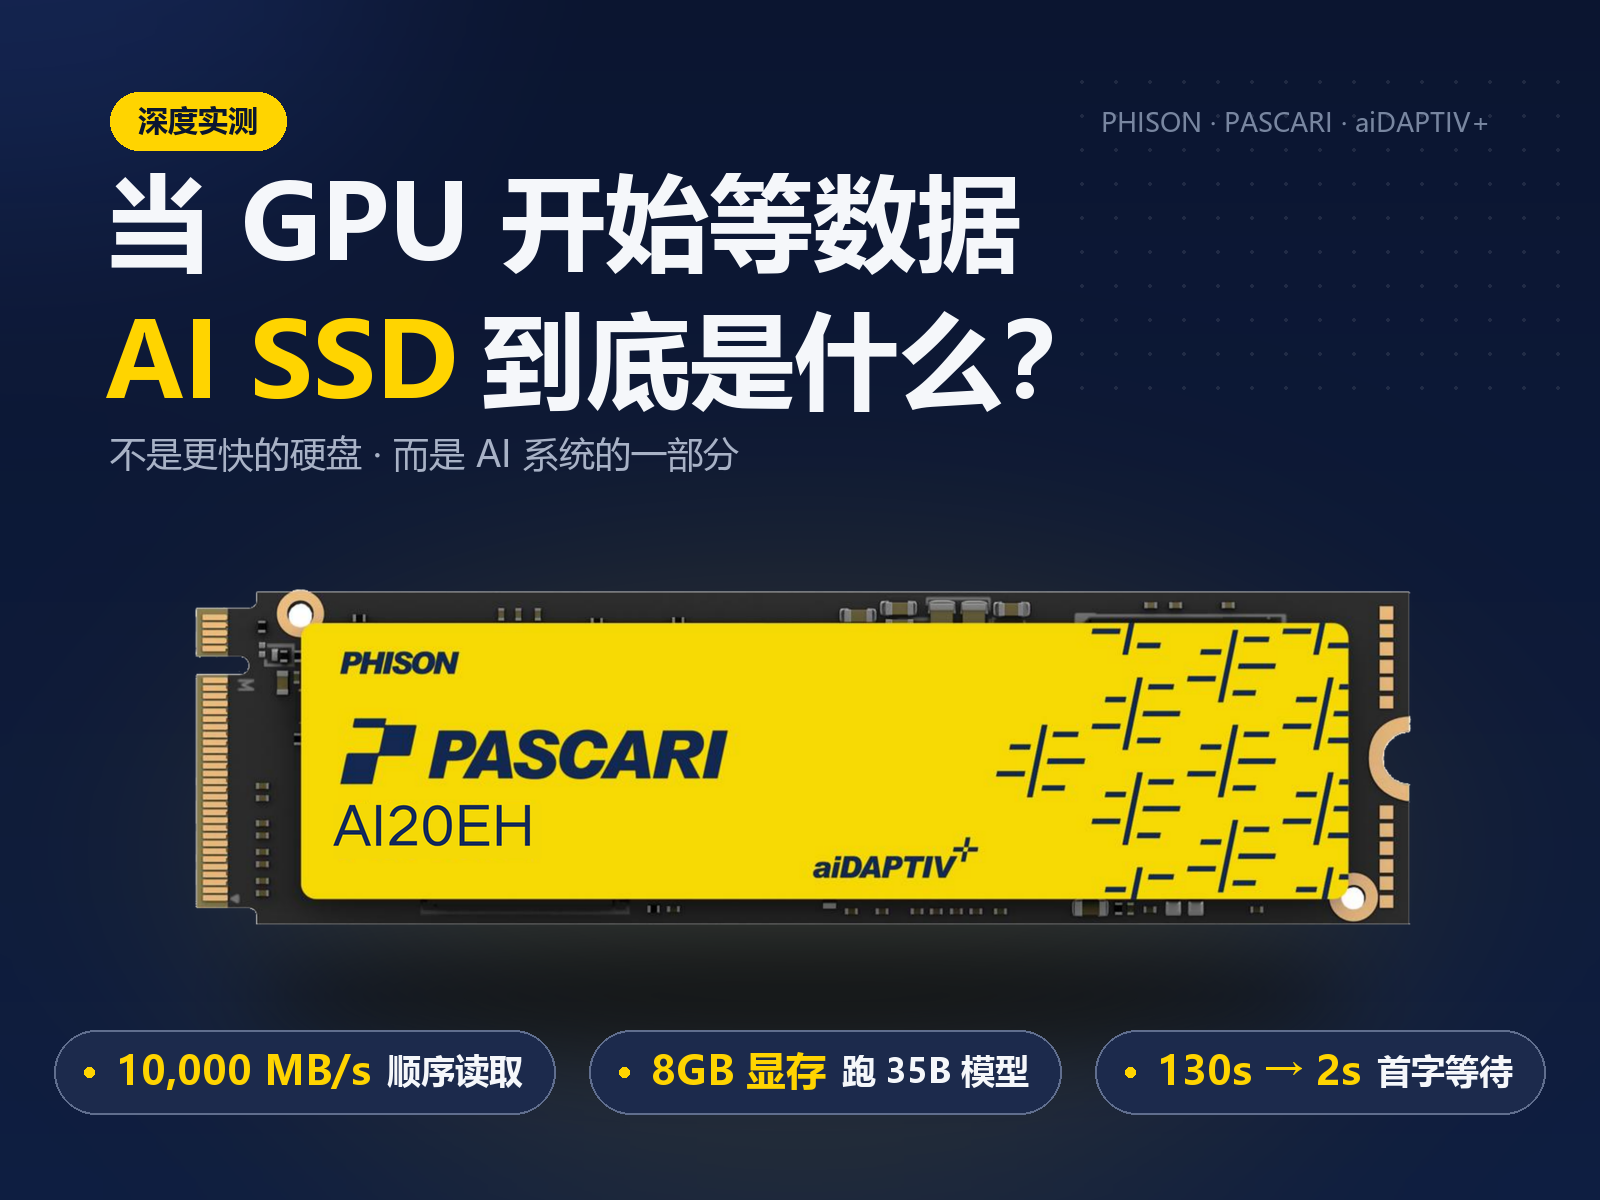
已经落地的AI SSD:群联 PASCARI AI20EH
上面这四个问题,不是理论推导出来的,而是被群联 PASCARI AI20EH一个一个解群联 PASCARI AI20EH 基于 aiDAPTIV+ 方案,PCIe Gen5.0 ×4 接口,M.2 2280 规格,提供 1TB 和 2TB 两个容量版本。
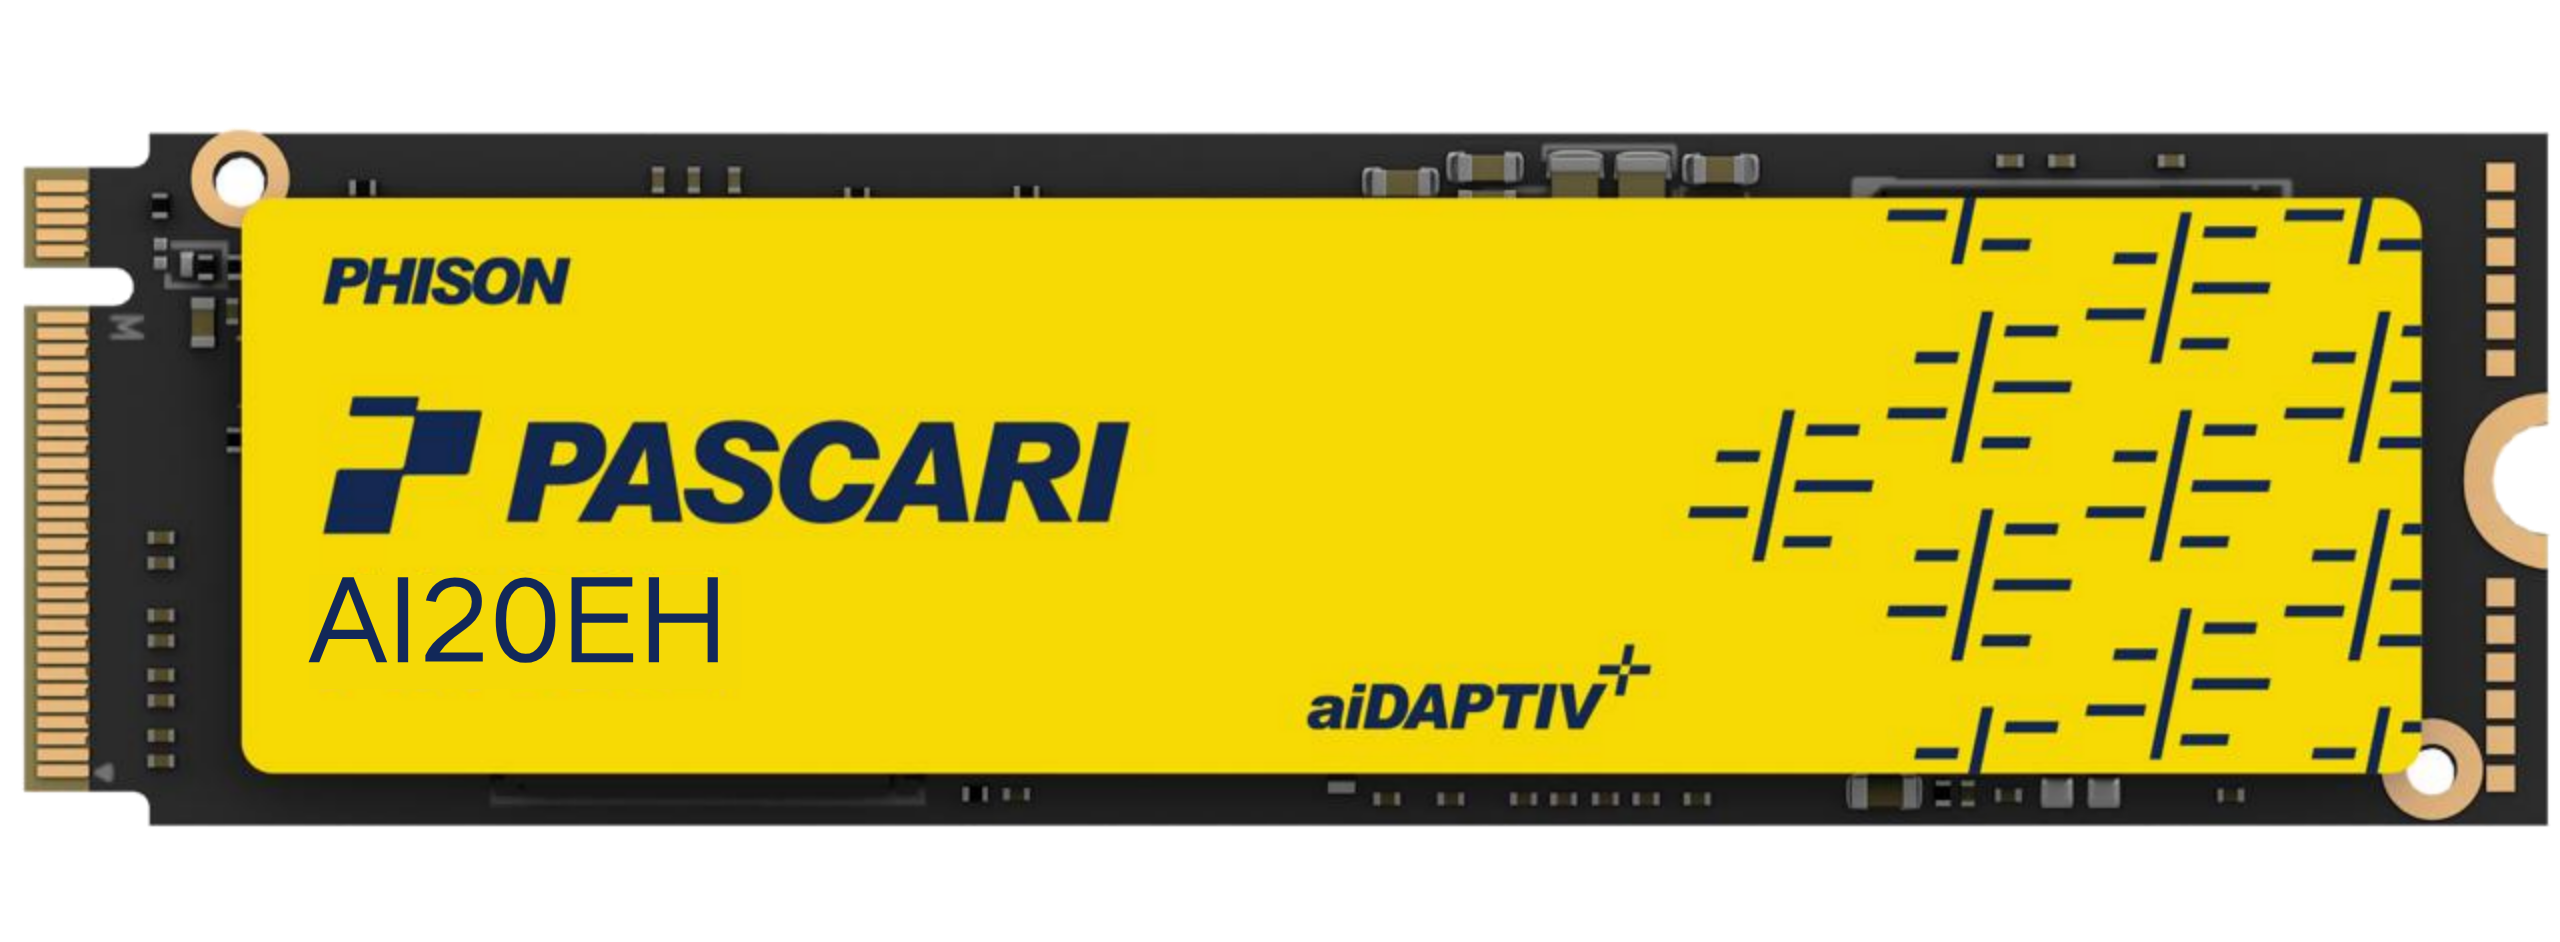
它最核心的设计是——一块盘,两个世界:
AI Cache 专用区 + Storage OS 存储区
1TB 版:AI Cache 85GB | Storage OS 768GB
2TB 版:AI Cache 128GB | Storage OS 1638GB
这块 SSD 在出厂时就把盘内空间划成两个分区:AI Cache 区专门承接 AI 的高频读写——模型权重、KV Cache、上下文缓存都发生在这里;而你的系统、软件、游戏、文件,照常放在 Storage OS 区,互不干扰。PART 05的"问题一"和"问题四"答案,落地形态就是它。
| AI20EH详细参数 | 1TB 版 | 2TB 版 |
|---|---|---|
| 外观尺寸 | M.2 2280-S3-M | |
| 颗粒类型 | 3D TLC NAND Flash | |
| 接口类型 | PCIe Gen5.0 ×4 | |
| AI Cache(AI 缓存专用) | 85GB | 128GB |
| Storage OS(存储专用) | 768GB | 1638GB |
| 顺序读取速度高达 | 10,000 MB/s | |
| 随机读取速度高达(IOPS) | 1300K | 1350K |
| AI Cache 顺序写入(MB/S) | 5,900 | 6,000 |
| AI Cache 随机写入(IOPS) | 1200K | 1250K |
| Storage OS 顺序写入(MB/S) | 8,600 | 8,900 |
| Storage OS 随机写入(IOPS) | 1500K | 1600K |
| 平均无故障时间 | 400 万小时 | |
| 耐用等级 | 600 TBW | 1200 TBW |
| 管理软件 | Herdsman 牧马人本地推理引擎 |
配套的 Herdsman 牧马人本地推理引擎负责把权重与缓存的调度做成开箱即用:模型一键下载、一键加载,不用自己折腾环境。
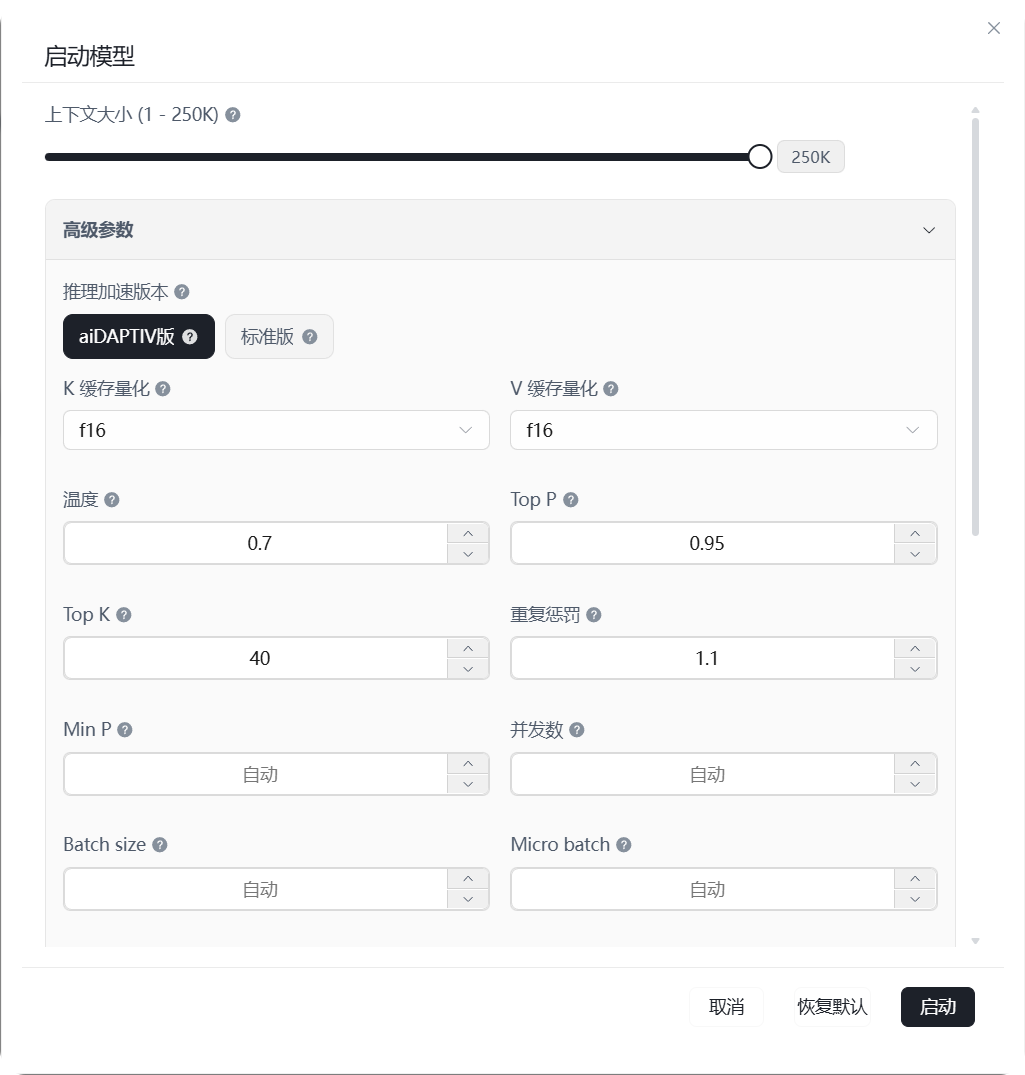
实测:它改变的不是速度,是"能不能"
参数是纸面上的,我们更想看它在真实机器上做了什么。于是做了两组测试,结论比参数表有意思得多。
实测一:8GB 显存,跑起 35B 的模型
测试平台用的是一块 RTX 5060,显存只有 8GB。按经验,这个显存连 13B 的 dense 模型都费劲,而我们要跑的是 Qwen3.6-35B-A3B——一个总参数量 35B 的 MoE 模型。
放在过去,这个组合想都不用想:35B 的模型权重,8GB 的显存,中间差着一个数量级,模型连加载这一关都过不去。
但在"显存 + 内存 + AI SSD"分层协作的架构下,模型权重不再需要全部挤进显存——热数据放显存,其余下沉到内存和 AI SSD,由 AI Cache 区持续供给。结果是:这个原本绝对跑不起来的模型,成功跑起来了。
这就是 AI SSD 和普通 SSD 最本质的区别:普通 SSD 的升级是"更快",AI SSD 的升级是"从不能到能"。
这意味着:你不需要为了跑大模型而换显卡。 一块 AI SSD,就能把你现有机器的模型容量天花板,直接抬高一整个档位。
实测二:首字等待,从 130 秒到 2 秒
第二个测试更贴近日常体验。大模型对话有一个绕不开的指标:TTFT(Time To First Token,首字等待时间) ——你按下回车之后,要等多久才看到第一个字。
在长对话场景下,如果每次都要重新计算全部上下文,这个等待会非常漫长:我们实测的两组数据里,TTFT 分别是 70 秒和 130 秒——尤其是后者,两分多钟过去屏幕上还是一片空白,体验可以说相当煎熬。
而把对话内容预缓存到 AI Cache 区之后,同样的场景,TTFT 直接变成了——
70 秒 → 2 秒
130 秒 → 2 秒
原理和前面讲的是同一件事:上下文缓存被放在了 AI Cache 专用区里,再次对话时直接供给、无需重算。省掉的不是"硬盘变快"省出来的时间,而是整段重复计算被消灭的时间。
从 130 秒到 2 秒,是 98% 的等待被砍掉。对长时间使用 AI 对话、Agent 工作流的人来说,这个差距就是"能用"和"好用"的差距。
所以,AI SSD 的价值到底在哪里?
把上面这些能力兑现到日常使用里,其实就三句话:
不用换显卡,就能跑更大的模型
8GB 显存跑起 35B 模型,原本要花在显卡上的预算,现在一块盘就能解决大半。
不用再等第一个字等到失去耐心
130 秒变 2 秒,长对话、Agent 连续工作流才真正具备"可用性"。
不用隔两年就担心换盘
AI 的高频读写被专属区域消化,600 / 1200 TBW 的耐用等级,让它比普通 SSD 更耐造。
所以,AI SSD 并不是简单地给 SSD 加上"AI"两个字。它背后真正发生的,是一次基础架构层面的变化:
过去是"计算找数据",未来越来越可能是"计算与数据协同"。
当一块 SSD 能让 8GB 显存的显卡跑起 35B 的模型,能把 130 秒的首字等待压缩到 2 秒,还能在日复一日的高频读写里守住寿命——
它就已经不只是硬盘了。
AI SSD 的未来,不是取代内存或显存,而是成为 AI 计算系统中不可或缺的高速数据基础设施。而这件事,已经发生在你我桌面的电脑上了。